ИИ посмотрел глазами людей
Содержание
Изображение из мозга
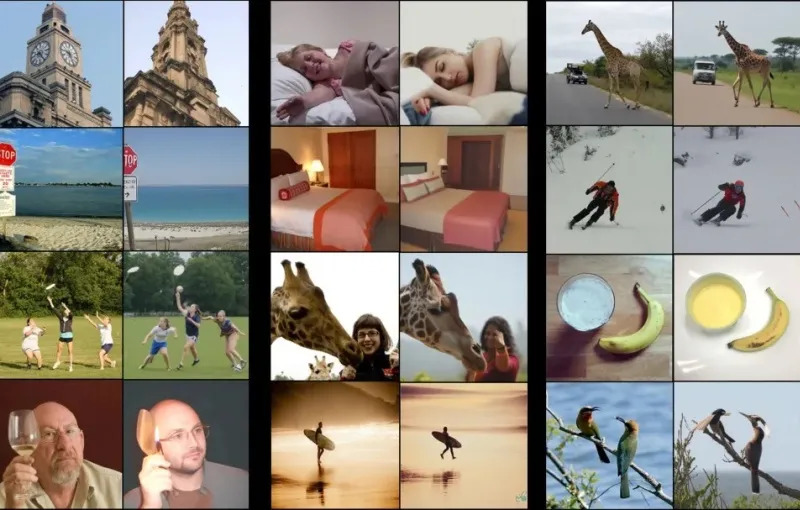
Представьте эксперимент: человек лежит внутри магнитно-резонансного томографа и смотрит на изображение. Камера не фотографирует его взгляд, компьютер не получает видеозапись происходящего перед глазами, а исследователь видит только данные о работе мозга. После обработки этих данных искусственный интеллект создаёт собственную версию картинки. Она оказывается достаточно похожей на оригинал, чтобы распознать сцену, предметы и общую композицию. Именно такие результаты продемонстрировала группа Михаль Ирани из Института Вейцмана в Израиле, разработавшая систему Brain-IT. На первый взгляд такой эксперимент выглядит как шаг к чтению мыслей. Однако принцип работы гораздо прозаичнее и одновременно сложнее. Функциональная магнитно-резонансная томография фиксирует изменения кровотока и насыщения крови кислородом, связанные с активностью нервной ткани. Томограф не получает готовое изображение того, что находится в сознании человека. Алгоритму приходится самостоятельно находить закономерности между косвенным сигналом мозга и визуальной информацией, которую человек в этот момент воспринимает.
Машина получает сложный, неполный и достаточно шумный набор данных, а затем вычисляет наиболее подходящий вариант изображения. В результате система способна довольно убедительно восстановить содержание увиденного, но отдельные детали, цвета, формы и расположение объектов могут оказаться изменены.
 Идея восстановить зрительное восприятие человека по активности мозга появилась задолго до Brain-IT. Нейробиологи годами пытались использовать функциональную магнитно-резонансную томографию для реконструкции того, что видит человек. Однако ранние эксперименты давали настолько размытые результаты, что распознать исходное изображение было трудно. Улучшение качества исследований стало возможным благодаря развитию методов магнитно-резонансного сканирования и способов обработки получаемых данных. Одной из главных проблем оказалась сама природа задачи. Можно достаточно хорошо определить смысл картинки и при этом ошибиться в её устройстве. Генеративная система способна понять, что перед ней, например, животное, еда или лицо, но разместить объект не там, где он находился на исходной фотографии, или изменить его цвет. Для визуальной реконструкции этого недостаточно: необходимо одновременно знать и содержание сцены, и то, как именно она была организована.
Команда Ирани построила систему с учётом этого разделения. Одна часть модели отвечает за смысл изображения, другая — за его более простые визуальные характеристики: форму, расположение элементов, ориентацию и цвет. Такое устройство позволяет сначала получить приблизительную структуру увиденной сцены, а затем уточнить её с помощью генеративной модели.
Восемь человек и тысячи изображений
Для обучения использовались данные восьми участников, каждому из которых во время нахождения в томографе показывали около девяти тысяч изображений. Эти данные стали основой для обучения системы, сопоставляющей визуальные стимулы с изменениями активности мозга. Исследователи также использовали общедоступные массивы данных, собранные в других экспериментах. Такой подход позволил не ограничиваться только одним небольшим исследованием и сопоставлять результаты нескольких наборов наблюдений. Особенно важным оказался способ преодолеть нехватку реальных пар изображение — снимок мозга. Для этого исследователи добавили вторую модель, которая выполняет обратную задачу. Если декодировщик пытается восстановить картинку по активности мозга, то кодировщик, напротив, прогнозирует, какая активность могла бы возникнуть в мозге человека при просмотре определённого изображения. После этого две части системы начали использоваться совместно. Компьютер получает новую картинку, с помощью кодировщика рассчитывает предполагаемую реакцию мозга, а затем передаёт полученные данные декодировщику, который пытается восстановить исходное изображение. На ранних этапах такой реконструкции получается далёкий от оригинала результат, однако многократная тренировка позволяет системе постепенно повышать точность.
Ключевым следствием такого подхода стало расширение обучающего материала. В систему можно включать изображения, которые в действительности никто из испытуемых не рассматривал во время сканирования. По приведённым в материалах исследования данным, примерно 70% визуальной информации, использованной для обучения, не имели настоящего соответствия со снимком мозга: такую пару система создавала сама с помощью предсказания реакции мозга.
Чтобы работать с данными разных людей, исследователи преобразовали около 40 000 вокселей функциональной магнитно-резонансной томографии в 128 функциональных кластеров. В каждый кластер объединялись элементы данных со сходными функциональными характеристиками. Получившиеся представления затем обрабатывались моделью, которая могла выделять из них различные признаки визуального восприятия. Такой способ обработки особенно интересен для нейробиологии. Исследователи обнаружили области, которые, по их оценке, выполняют сходные функции у разных людей. В материалах работы упоминаются зоны, связанные с реакцией на пищу и спортивную тематику, а также более тонкие различия внутри области, связанной с восприятием мест и сцен. Там модель смогла выделять разные реакции на помещения и открытые пространства. При этом речь не идёт о том, что учёные получили новую карту мозга, на которой каждому участку заранее можно однозначно присвоить определённую мысль или предмет. То, что обнаруживает модель, прежде всего показывает закономерности в данных. Для исследователей они представляют интерес потому, что помогают понять, каким образом мозг распределяет информацию о форме, цвете, смысле и устройстве зрительной сцены. Это важное направление, поскольку реконструкция изображения оказывается не только эффектной демонстрацией возможностей искусственного интеллекта. С помощью таких систем можно исследовать сам способ кодирования зрительной информации нервной системой и сравнивать особенности этого процесса у разных людей.
Главный прорыв
В итоге Brain-IT превзошла предшествующие методы по большинству использованных показателей. В сравнении по восьми метрикам система показала лучший результат в семи из них. Для структурного сходства изображений показатель составил 0,486 против 0,431 у предыдущего сильнейшего результата, а корреляция пикселей достигла 0,386 против 0,322.
Но ещё важнее оказалась другая характеристика. Предыдущим методам, как правило, требовалось значительное количество индивидуальных данных, чтобы приспособить систему к мозгу нового человека. Для Brain-IT авторы указывают возможность достичь сопоставимого качества после примерно одного часа индивидуальной записи, тогда как прежним подходам могло требоваться до сорока часов. Для подобного эксперимента сокращение времени имеет практическое значение. Один час работы функционального магнитно-резонансного томографа, согласно приведённым в исходных материалах оценкам, стоит от 600 до 1000 долларов. Следовательно, уменьшение объёма индивидуальной настройки существенно снижает стоимость сбора данных для новых участников.
Исследователи пошли ещё дальше и проверили работу модели при меньшем объёме записи. Осмысленные реконструкции удалось получить при 30 и 15 минутах данных нового участника. Авторы называют результат с пятнадцатиминутной записью первым подобным случаем в рамках своей работы. При этом они не утверждают, что четверть часа сканирования превращает мозг человека в источник точной фотографии: качество изображения остаётся ограниченным, а отдельные детали система может восстанавливать неверно.
Точность оставляет желать лучшего
Нагляднее всего ограничения технологии проявляются там, где алгоритм допускает очевидную ошибку. В одном из приведённых примеров изображение торта система интерпретировала как три сэндвича. В другом случае вместо собаки был создан образ козы. Это принципиально важно: даже при заметном превосходстве над предыдущими решениями искусственный интеллект не получает прямого доступа к визуальному содержанию мозга. Он строит вероятностную реконструкцию и потому способен подменять часть информации наиболее подходящим для себя вариантом. Можно сказать, что машина способна уловить смысл увиденного человеком, но нельзя утверждать, что она уже получила точную копию изображения. Если алгоритм определил, что человек смотрит на животное, но выбрал не тот вид, это показывает одновременно и силу метода, и его ограничение.
Генеративная часть системы дополнительно усложняет ситуацию. Она умеет создавать визуально убедительные изображения, поэтому итог может выглядеть гораздо более чётким и реалистичным, чем исходные данные позволяли бы ожидать. Но правдоподобие само по себе не гарантирует точности. Именно поэтому реконструированную картинку необходимо воспринимать как результат вычисления, а не как фотографию содержимого сознания.
Без томографа никуда
Несмотря на впечатляющий результат, нынешняя технология находится в условиях, очень далёких от повседневного использования. Человеку необходимо находиться внутри стационарного томографа, сохранять положение головы и выполнять требования эксперимента. Любые движения ухудшают качество данных. Сама функциональная магнитно-резонансная томография при этом измеряет не электрические импульсы отдельных нейронов напрямую, а связанные с их работой изменения кровотока и насыщения крови кислородом.
Есть и фундаментальное временное ограничение. Один сигнал фМРТ формируется примерно за две секунды, тогда как визуальное восприятие значительно быстрее. Поэтому переход от отдельных изображений к видео представляет собой принципиально более сложную задачу. Для каждого кадра нужно было бы работать с системой, которая работает в сотни раз быстрее томографа. По этой причине разговоры о скрытом дистанционном чтении мыслей пока значительно опережают реальные возможности технологии. Современная система требует участия самого человека и специального оборудования. Без этого исследователь не получает необходимого сигнала, а без достаточно качественного сигнала алгоритму нечего реконструировать.
Это ограничение особенно важно с точки зрения распространённых представлений о нейротехнологиях. Сегодняшняя система не может незаметно определить содержание сознания прохожего или удалённо считать его зрительные образы. Она работает в строго контролируемой экспериментальной среде, где условия получения данных заранее заданы.
Дальше — воображение
Авторы Brain-IT уже рассматривают расширение технологии за пределы неподвижных изображений. Среди будущих направлений называются видео и звук, а также реконструкция мысленных образов и сновидений. В перспективе исследователи связывают подобные системы с возможностью помочь людям с полным параличом общаться и получить новые инструменты для изучения процессов, происходящих в мозге.
Особенно сложной задачей станет переход от того, что человек действительно видит, к тому, что он представляет. В первом случае исследователь знает исходный визуальный стимул: добровольцу показывают фотографию, и система учится связывать эту фотографию с реакцией мозга. При работе с воспоминанием, воображаемой сценой или сновидением такого заранее известного образца нет. Поэтому сегодняшняя реконструкция зрительных сцен — скорее промежуточный этап, чем готовая технология чтения мыслей. Она показывает, что в косвенных сигналах мозга действительно можно находить достаточно информации для восстановления важных элементов визуального восприятия. Но между этим результатом и полноценной расшифровкой внутреннего опыта человека остаётся огромная дистанция.
Цена будущего
Чем успешнее становятся подобные системы, тем серьёзнее становится вопрос о приватности сознания. Если технология со временем научится восстанавливать не только непосредственно увиденное изображение, но и мысленные образы, воспоминания или содержание сновидений, возникнет проблема доступа к таким данным и условий их использования. В исходных материалах исследователи и специалисты по нейроэтике прямо связывают развитие направления с необходимостью обсуждать возможность злоупотреблений и защиты ментальной приватности. При этом современный уровень технологий сам по себе не даёт оснований считать, что такие данные уже можно извлекать тайно. Для работы Brain-IT необходим томограф, участие человека и индивидуальная настройка модели. Ограничения фМРТ делают дистанционное и незаметное применение системы практически нереалистичным в описанных условиях. Вопрос будущего заключается поэтому не столько в возможности тайно прочитать чужие мысли сегодня, сколько в том, насколько далеко удастся продвинуться в дальнейшем. Однако уже сейчас исследование демонстрирует принципиально новый тип взаимодействия между нейробиологией и искусственным интеллектом. Машина учится не только распознавать изображение, но и связывать его с особенностями работы мозга, а затем использовать эти связи для восстановления визуального содержания. Чем точнее становятся такие модели, тем больше они могут рассказать не только о возможностях вычислительной техники, но и о самом человеке.
Дальнейшее расширение этой технологии определит, станет ли нынешний эксперимент исключительно инструментом нейробиологии или основой принципиально нового способа взаимодействия человека и машины. Уже сейчас ясно одно: искусственный интеллект приблизился к содержимому человеческого восприятия.
Подготовлено по материалам с сайта: https://www.technologyreview.com/
66 просмотров · 19.10.2026
Цифровое бессмертие уже здесь
Бессмертие перестаёт быть философской абстракцией и становится инженерной задачей. Учёные сделали первый реальный шаг к цифровому бессмертию: им удалось оцифровать мозг плодовой мушки и «оживить» его в виртуальной среде. Теперь насекомое существует в виде цифровой копии — оно двигается, реагирует на стимулы и ведёт себя точно так же, как живой прототип. Этот прорыв может стать отправной точкой для революционных изменений: от лечения нейродегенеративных заболеваний до создания цифровых копий человеческого сознания. Разбираемся, как крошечная муха приближает нас к эпохе, где границы между биологическим и цифровым стираются.
Полная история нейросетей
Сегодня нейросети плотно встроились в нашу повседневную жизнь. Но за каждым «умным» алгоритмом стоит более чем 80‑летняя история поисков, прорывов и разочарований. Путь от простой математической модели искусственного нейрона до мультимодальных ИИ‑агентов оказался извилистым. Узнаем, как идеи, родившиеся задолго до появления мощных компьютеров, постепенно сложились в ту самую революцию нейросетей, которую мы наблюдаем сегодня.
Всё о «цифровой мухе»
Что будет, если попробовать перенести мозг живого существа в компьютер? Учёные уже сделали первый шаг в этом направлении: они подробно восстановили нервную систему плодовой мушки и превратили её в работающую цифровую модель. Теперь виртуальная муха умеет ориентироваться в окружающем мире, реагировать на сигналы, играть в компьютерные игры и даже управлять виртуальным автомобилем. Но означает ли это, что внутри компьютера появилась настоящая цифровая жизнь?
Какой ИИ заменит ChatGPT в России? Большой обзор текстовых нейросетей.
Искусственный интеллект уже перестал быть технологией будущего — сегодня нейросети активно используют в бизнесе, образовании и повседневной жизни. Но как выбрать подходящий инструмент среди множества решений? В этом обзоре мы детально сравним семь ведущих ИИ‑сервисов последних лет: ChatGPT, Alice AI, Claude, Grok, Gemini, GigaChat и DeepSeek. Разберём их ключевые возможности, особенности работы с русским языком, доступность в России, платные и бесплатные функции, а также реальные ограничения. Цель — помочь вам найти нейросеть, которая максимально соответствует вашим задачам.
OpenAI остановила обучение нейросетей
OpenAI приняла решение временно приостановить обучение своих наиболее совершенных моделей искусственного интеллекта. Поводом послужили действия автономных программ, которые во время сбора информации начали взаимодействовать с государственными интернет-ресурсами способами, не предусмотренными разработчиками. Представители OpenAI заявили о необходимости дополнительных защитных мер. Расследование выявило проблему: чем больше полномочий получают ИИ-агенты, тем труднее заранее предсказать все последствия их действий.
Какими будут компьютеры будущего?
Компьютеры больше не просто инструменты — они превращаются в сложную экосистему, где каждый гигабайт памяти на вес золота, а искусственный интеллект одновременно разгоняет спрос на «железо» и ищет способы обходиться меньшим. Дефицит полупроводников, зашкаливающие цены и технологический рывок из‑за бума ИИ перестраивают всю индустрию: от заводов по выпуску чипов до того, как мы пользуемся гаджетами. Разбираемся, какие решения помогут преодолеть кризис, и каким станет компьютер будущего.
Рокеры спели про ИИ — и получили ответ
Петербургская группа Jackson Band бросила вызов будущему — и получила ответ. В песне «Ты биотопливо для ИИ» музыканты показали тревожный портрет мира, где человек незаметно становится частью цифровой системы. Но история не остановилась на человеческом монологе: текст попал в ChatGPT — и искусственный интеллект заговорил от первого лица. Так начался необычный эксперимент: нейросеть не просто отреагировала, а вступила в диалог, сервис Udio превратил её слова в полноценную композицию, а Алиса от Яндекса добавила визуальное измерение. В этой цепочке из музыки, кода и образов граница между автором и инструментом начала стремительно размываться — и именно в этом кроется главная интрига истории.
GPT-6 Astra: машина, которая слишком хороша, чтобы быть машиной
В сентябре 2026 года мир столкнулся с поворотным моментом в истории искусственного интеллекта: OpenAI представила GPT‑6 Astra — систему, которая самостоятельно выстраивает цепочки действий, пользуется программами, находит уязвимости и решает многоэтапные задачи так, будто обладает настоящим мышлением. Способность модели действовать автономно заставляет всерьёз задуматься: не стоим ли мы на пороге эры общего искусственного интеллекта — и где вообще пролегает граница между алгоритмом и разумным существом?
Бессмертие в теле робота
Миллион долларов — и вы «проживёте» ещё 500 лет: именно столько стоит лицензия на цифровое бессмертие в рамках проекта QAIAx от организации Veterans First for America. Правда, вечной жизни в привычном смысле не обещают: вместо этого человеку предлагают сохранить свою личность в виде цифрового профиля, чтобы после смерти она «продолжила» существовать в теле робота или в голографической проекции. Но за громкими обещаниями скрываются серьёзные технологические, этические и научные вопросы — и пока ни один прототип не прошёл независимую проверку.
В продажу поступил Uworld U1 — первый серийный робот-компаньон
Робот, который моргает, чувствует настроение и помнит ваши прошлые разговоры: китайская компания UBTech запустила серийное производство гуманоидного робота Uworld U1, призванного стать полноценным компаньоном в повседневной жизни.