Полная история нейросетей
Содержание
Машины были не всегда
Сегодня нейросети настолько прочно вошли в обычную жизнь, что человек уже далеко не всегда замечает их присутствие. Смартфон распознаёт лицо владельца, камера автоматически улучшает снимок, поисковая система понимает вопрос, написанный разговорным языком, программа переводит иностранную речь в реальном времени, навигатор прогнозирует ситуацию на дороге, а генеративная модель может написать текст, нарисовать изображение, разобрать документ или предложить компьютерную программу. Для современного пользователя всё это выглядит как единая технология, которую обычно называют искусственным интеллектом. Однако на самом деле за нынешним бумом стоят несколько разных научных направлений, развивавшихся десятилетиями. Нейронные сети являются одной из центральных ветвей этой истории, но они не возникли вместе с Интернетом, смартфонами или большими языковыми моделями. Их происхождение уходит в первую половину XX века, когда математики и нейрофизиологи только начинали всерьёз обсуждать возможность описать работу мозга и создать его искусственную имитацию. Путь к современному ИИ был извилистым. Исследователи несколько раз считали, что до создания разумной машины остались считанные годы, а затем сталкивались с нерешаемыми в те годы проблемами. Были периоды бурного энтузиазма, когда новые системы производили впечатление почти волшебных, и были периоды разочарования, когда финансирование сокращалось, лаборатории закрывались, а нейронные сети считались бесперспективным направлением. Многие идеи, которые сегодня кажутся очевидными, возникли задолго до того, как появились вычислительные мощности для их практической реализации. Современная революция нейросетей представляет собой не внезапное рождение новой науки, а результат очень долгого накопления знаний, методов, данных и вычислительных ресурсов.
Если отбросить рекламные слоганы и популярные мифы, история нейросетей становится даже интереснее, чем с ними. В её начале не было машины, которая «понимала» текст или распознавала фотографии. Не было даже привычного нам слова «нейросеть» в современном смысле. Были учёные, пытавшиеся ответить на достаточно абстрактный вопрос: можно ли представить работу нервной системы как вычислительный процесс, и можно ли построить искусственную систему из большого количества простых элементов, которая будет менять своё поведение в зависимости от получаемой информации.
Идея искусственного мозга
К середине XX века несколько научных дисциплин начали сходиться в одной точке. Развивалась математическая логика, благодаря которой становилось возможно описывать рассуждения формальными правилами. Появлялись первые ЭВМ, показывавшие, что математические операции можно выполнять автоматически. Параллельно физиологи всё больше узнавали о строении нервной системы. Возникала идея, которая в дальнейшем стала фундаментальной для искусственных нейросетей: даже если человеческий мозг чрезвычайно сложен, его отдельные элементы могут подчиняться сравнительно простым правилам, а сложное поведение может возникать из взаимодействия огромного количества таких элементов.
 В 1943 году американский нейрофизиолог Уоррен Маккаллок и математик Уолтер Питтс опубликовали работу «Логический анализ идей, присущих нервной деятельности». В ней они предложили математическую модель нейрона, способного получать входные сигналы и переключаться между состояниями по формальным правилам. Их модель была очень далека от реального биологического нейрона и не пыталась точно воспроизвести все процессы нервной клетки. Значение работы было в другом: авторы показали, что сеть простых элементов, связанных определённым образом, может выполнять операции, которые можно описать средствами математической логики. Это стало одним из фундаментальных теоретических оснований будущего коннекционизма, то есть подхода, в котором сложные вычислительные способности рассматриваются как результат взаимодействия множества связанных между собой простых компонентов.
Важно понимать, что Маккаллок и Питтс не создали «искусственный мозг». Их модель ничего не знала об окружающем мире, не училась в современном смысле и не обладала памятью или пониманием. Но сама идея была чрезвычайно важна. Если логическую операцию можно представить работой искусственного нейрона, а искусственные нейроны можно объединять в сети, возникает возможность рассматривать вычисление не только как последовательность команд, написанных человеком, но и как работу большой совокупности взаимосвязанных элементов. Впоследствии именно эта логика приведёт к архитектурам, которые будут состоять уже не из нескольких теоретических нейронов, а из миллиардов числовых параметров.
Обучение как изменение связей
 В 1949 году канадский психолог Дональд Хебб опубликовал книгу «Организация поведения», в которой сформулировал влиятельную гипотезу о связи между активностью нейронов и изменением силы их соединений. В упрощённом виде идея заключается в том, что если определённые нейроны регулярно активируются одновременно, связи между ними могут укрепляться. Саму теорию Хебба нельзя считать готовым алгоритмом современного машинного обучения, однако её значение для истории коннекционистского подхода было огромным: нейронная сеть начинает рассматриваться не как фиксированная конструкция, а как система, структура которой способна изменяться под воздействием опыта.
Это очень важный переход в логике развития ИИ. В классической программе программист заранее описывает правила, которые компьютер должен выполнять. В обучающейся системе правила поведения не обязательно задаются напрямую. Вместо этого компьютеру дают данные и механизм изменения внутренних параметров. Машина постепенно настраивает свою структуру так, чтобы лучше выполнять поставленную задачу. В современных нейросетях эта идея приобрела совершенно другой масштаб и математическую форму, однако сама идея осталась удивительно похожей: обучение означает изменение параметров системы под воздействием опыта.
Тьюринг и вопрос о машинах
 В 1950 году британский математик Алан Тьюринг опубликовал в философском журнале Mind статью «Вычислительная техника и интеллект». Уже первая фраза задавала направление всей последующей дискуссии: Тьюринг предложил рассмотреть вопрос о том, могут ли машины мыслить. Но вместо бесконечного спора о том, что именно означает слово «мыслить», он предложил исследовать наблюдаемое поведение машины. Так появился знаменитый «игровой» эксперимент, позднее получивший название теста Тьюринга. В той же статье Тьюринг отдельно обсуждал обучающиеся машины и возможность того, что компьютер не обязательно должен быть полностью запрограммирован заранее, а может менять своё поведение в результате обучения. Для истории нейросетей это особенно важно, потому что идея машины, способной не только исполнять заранее написанные инструкции, но и учиться, занимала центральное место в последующих десятилетиях исследований. Сам Тьюринг при этом не предлагал современную нейронную сеть. Его рассуждения были гораздо шире и касались природы вычисления, интеллекта и обучения. Но в историческом плане его работа стала одним из мостов между математической теорией вычислений и будущей наукой об искусственном интеллекте. Она помогла сформулировать принципиально новый подход: вместо вопроса о том, напоминает ли внутреннее устройство машины человеческий мозг, можно исследовать, какие способности она демонстрирует и каким образом эти способности возникают. В современной дискуссии об ИИ эта мысль всё ещё остаётся актуальной, потому что поведение сложной модели далеко не всегда можно напрямую связать с тем, как устроена человеческая психика или биологическая нервная система.
Перцептрон: первая большая надежда
 В конце 1950-х годов американский исследователь Фрэнк Розенблатт разработал перцептрон — одну из самых известных ранних моделей обучающейся нейронной сети. В 1958 году появилась его статья «Персептрон: Вероятностная модель хранения и организации информации в мозге». В отличие от ранней модели Маккаллока и Питтса, перцептрон был не просто математическим описанием логических операций. Он мог изменять веса своих связей на основе примеров, то есть действительно обучаться.
Для человека, знакомого с современным машинным обучением, принцип перцептрона легко объяснить на простом примере. Представим, что машине показывают два типа объектов и каждый раз сообщают, к какому классу относится увиденное. Внутри системы есть числовые коэффициенты, называемые весами. После правильного ответа веса почти не меняются, а после ошибки корректируются таким образом, чтобы в следующий раз система с большей вероятностью пришла к правильному решению. Сам перцептрон был крайне прост по сравнению с сегодняшними моделями, но здесь появилась идея, без которой современный ИИ был бы невозможен: правильное поведение можно не полностью программировать вручную, а получать через обучение на примерах.
Вокруг перцептрона возник большой общественный интерес. В газетах и научно-популярной прессе будущие возможности подобных систем иногда представлялись намного шире того, что технология действительно умела делать.
Эта проблема будет повторяться в истории искусственного интеллекта снова и снова: даже довольно скромный эксперимент способен породить гораздо более смелые ожидания, чем позволяют реальные возможности алгоритма. Разница между демонстрацией конкретного навыка и созданием универсального интеллекта уже тогда была огромной, но в общественном сознании эти вещи нередко смешивались.
Рождение искусственного интеллекта
 В середине 1950-х годов параллельно с нейросетевыми исследованиями формировалось другое направление. Джон Маккарти, Марвин Минский, Клод Шеннон и Натаниэл Рочестер предложили в 1955 году провести исследовательский проект, посвящённый машинному интеллекту, а летом 1956 года состоялся Дартмутский семинар. Именно в предложении этого проекта появилось выражение «искусственный интеллект». Участники исходили из довольно смелой идеи: если аспекты обучения и интеллектуальной деятельности можно описать достаточно точно, то машины в принципе смогут моделировать эти процессы.
При этом ранний искусственный интеллект вовсе не был синонимом нейронных сетей. Внутри молодой области существовали разные подходы. Одни учёные предпочитали символические методы и считали, что разумнее всего описывать интеллектуальную деятельность через правила, логические структуры и процедуры поиска. Другие продолжали развивать идеи искусственных нейронных сетей. Это противостояние иногда упрощённо представляют как спор между «правильным» и «неправильным» путём, хотя исторически оба направления дали важные результаты. Символический ИИ оказался полезен для целого ряда задач, а нейросетевой подход спустя десятилетия стал доминирующим во многих областях машинного обучения.
Нейрон не всемогущ
В 1960-е годы выяснилось, что возможности простого перцептрона имеют серьёзные математические ограничения. В 1969 году Марвин Минский и Сеймур Паперт опубликовали книгу «Перцептроны», в которой подробно анализировали возможности таких систем. Особое внимание привлекал классический пример функции XOR, которую однослойный перцептрон не мог правильно разделить. Эта книга сыграла важную роль в истории направления, потому что она показала, что добавление одного простого обучающегося элемента ещё не превращает сеть в универсальную интеллектуальную систему. Позднее этот эпизод превратился в один из самых распространённых мифов истории ИИ. Иногда утверждают, что Минский и Паперт доказали невозможность нейронных сетей вообще. Это неверно. Их строгий анализ касался возможностей перцептронов определённого типа, прежде всего однослойных систем. Теоретически многослойные сети обладали намного более широкими возможностями, однако в конце 1960-х годов проблема заключалась в другом: эффективного и удобного метода обучения таких многослойных конструкций ещё не было. В результате теоретическая возможность существовала, но практической технологии, позволяющей ею воспользоваться, в распоряжении исследователей фактически не было.
Ажиотаж пошёл на спад
 В 1970-е годы интерес к искусственному интеллекту во многих направлениях начал сталкиваться с реальностью. Компьютеры были слишком медленными, память слишком дорогой, объём доступных данных оставался небольшим, а обещания ранних исследовательских программ часто оказывались слишком оптимистичными. В разных странах и проектах финансирование сокращалось, а ожидания снижались. В этот период особенно заметную роль играли экспертные системы. Их разработчики исходили из предположения, что многие задачи можно решить, если достаточно хорошо описать знания специалистов в виде правил. Такой подход действительно давал впечатляющие результаты в отдельных областях, где круг возможных ситуаций был сравнительно ограничен. Однако постепенно обнаруживалась фундаментальная проблема: реальный мир содержит слишком много исключений, неоднозначностей и скрытого контекста. Для человека многие вещи очевидны без специального объяснения, тогда как компьютеру необходимо было либо сообщить соответствующее правило, либо дать возможность самостоятельно вывести закономерность из данных. Проблема оказалась особенно заметной тогда, когда система должна была работать не в узкой и заранее ограниченной предметной области, а с естественными изображениями, речью и человеческим языком. Человеку не нужно каждый раз составлять формальную инструкцию, объясняющую, чем один объект отличается от другого. Мы учимся на примерах, постепенно формируем обобщения и используем накопленный опыт в новых ситуациях. Нейросетевой подход как раз позволял попытаться перенести эту логику в вычислительную систему.
Возвращение нейронных сетей
Ключевой проблемой оставалось обучение многослойной сети. Если модель содержит скрытые слои, а правильность решения оценивается только по конечному результату, нужно каким-то образом определить, какую часть ошибки следует «приписать» каждому внутреннему параметру. В 1980-е годы были значительно усовершенствованы методы, позволившие решить эту задачу на практике. В 1986 году Дэвид Румельхарт, Джеффри Хинтон и Рональд Уильямс опубликовали в журнале Nature работу «Изучение представлений с помощью ошибок, распространяющихся в обратном направлении», в которой описали процедуру обратного распространения ошибки для многослойных нейронных сетей.
Принцип можно объяснить без сложной математики. Представим систему, которая делает прогноз, получает информацию о том, насколько он далёк от правильного ответа, а затем пытается понять, какие внутренние параметры сильнее всего способствовали ошибке. Информация об ошибке распространяется от выхода сети назад через её слои, благодаря чему можно вычислить направления, в которых следует немного изменить веса. Этот процесс повторяется огромное количество раз. Один шаг почти ничего не меняет, но миллионы повторений постепенно настраивают сеть так, чтобы её ответы становились лучше.
Особенно важным стало то, что скрытые слои могли начинать формировать полезные внутренние представления данных. Иными словами, исследователь не обязательно должен заранее объяснять машине, какие именно признаки нужно искать. Сеть может обнаружить их сама. Для компьютерного зрения это со временем означало возможность автоматически находить линии, контуры, формы и более сложные структуры. Для речи и языка характер внутренней организации был другим, но общий принцип оставался тем же: система самостоятельно строит представления, необходимые ей для решения задачи.
Машинное зрение
Развитие нейронных сетей особенно заметно проявилось в компьютерном зрении. Изображение представляет собой огромный массив чисел, но соседние пиксели связаны между собой гораздо сильнее, чем пиксели, находящиеся на большом расстоянии. Это означает, что при обработке фотографии имеет смысл искать локальные признаки, а затем объединять их в более сложные структуры. Именно эту идею эффективно использовали свёрточные нейронные сети.
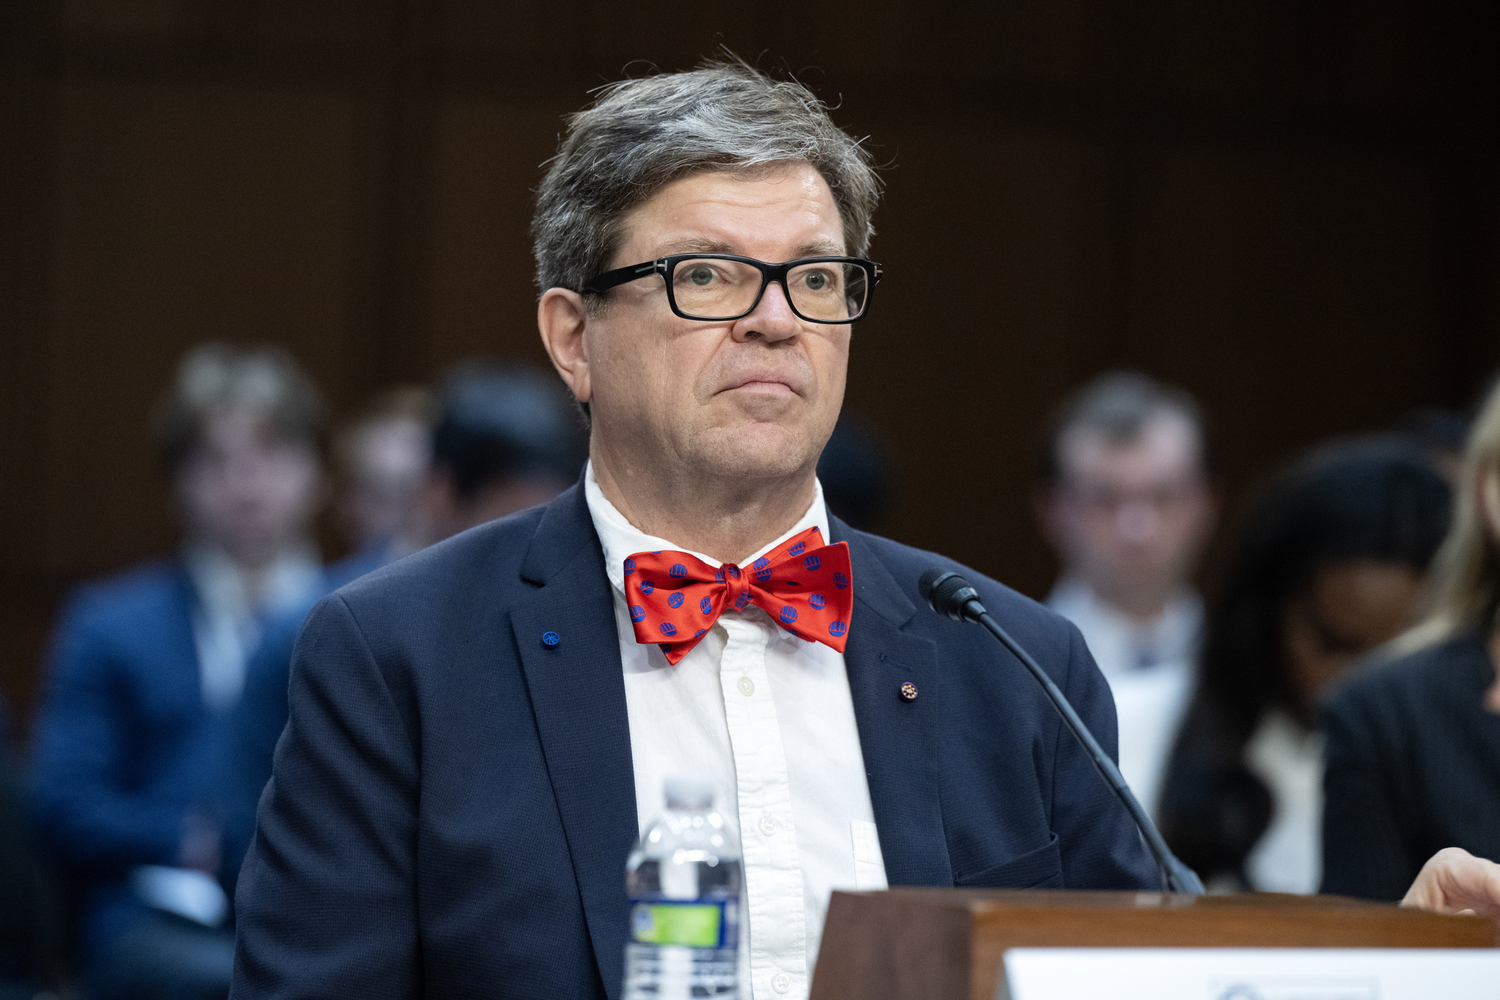 Работы Яна ЛеКуна и других исследователей сделали свёрточные сети одним из основных инструментов распознавания изображений и документов. В таких системах ранние слои способны обнаруживать относительно простые структуры вроде границ и контуров, а последующие слои используют эти признаки для построения более сложных представлений. В 1990-е годы нейросетевые методы уже применялись к практическим задачам распознавания рукописных символов и документов. Это был важный этап, потому что искусственная нейросеть постепенно переставала быть только объектом теоретического изучения и превращалась в реальный инженерный инструмент.
Параллельно развивались рекуррентные нейронные сети, предназначенные для последовательностей. Их особенность заключалась в том, что состояние сети переносилось от одного элемента последовательности к следующему. Это позволяло работать с речью и текстом, где порядок элементов имеет принципиальное значение. Однако у рекуррентных моделей возникли проблемы с очень длинными зависимостями: информация о начале длинной последовательности могла плохо сохраняться при прохождении через множество шагов.
В 1997 году Зепп Хохрайтер и Юрген Шмидхубер предложили архитектуру Long Short-Term Memory, более известную как LSTM. Она была разработана именно для того, чтобы позволить рекуррентным сетям лучше сохранять информацию на больших временных промежутках и облегчить обучение длинных зависимостей. LSTM впоследствии оказала огромное влияние на обработку речи, текста и других последовательностей и долгое время считалась одной из наиболее эффективных архитектур своего класса.
Здесь возникает один из главных парадоксов всей истории. Многие необходимые идеи были известны задолго до того, как началась современная революция нейросетей. Существовали искусственные нейроны, методы обучения, многослойные сети, свёрточные архитектуры, рекуррентные модели и LSTM. Но мощность этих идей была ограничена возможностями техники и количеством доступных данных. Чтобы обучить большую модель, нужны огромные вычислительные ресурсы, а чтобы эти вычисления имели смысл, нужны большие массивы хороших данных. Ситуация начала быстро меняться в 2000-е годы. Интернет превратился в гигантское хранилище текстов и изображений. Цифровая фотография стала массовой. Люди начали загружать в сеть видео, музыку и документы в невиданных ранее объёмах. Одновременно графические процессоры, или GPU, стали настолько мощными, что оказалось выгодно использовать их не только для вывода компьютерной графики, но и для ускорения математических операций, лежащих в основе обучения нейросетей. Получился своеобразный технологический замкнутый круг. Большие данные позволяли учить более мощные модели, более мощные модели требовали более быстрых вычислений, развитие вычислений делало возможными ещё более крупные модели, а увеличение масштаба снова повышало потребность в данных. В какой-то момент старые идеи получили совершенно новую вычислительную среду. Это и стало одним из главных условий возникновения эпохи глубокого обучения.
Рубеж 2006 года
В 2006 году Джеффри Хинтон, Саймон Осиндеро и И Вэй-Те опубликовали работу о быстром обучении глубоких сетей убеждений, или Deep Belief Networks. Эти исследования стали частью более широкой волны работ, которая снова привлекла внимание к многослойным нейронным архитектурам. Значение этих исследований нельзя свести к одной конкретной технике: они помогли вернуть глубокое обучение в центр обсуждения и показали, что при правильном подходе более глубокие структуры действительно могут быть практически полезными.
Показательно, что возвращение глубоких сетей произошло ещё до главной технологической волны 2012 года. Иными словами, «революция 2012 года» не началась в вакууме. К тому времени уже существовало сообщество исследователей, которые продолжали работать над глубокими моделями, разрабатывали методы оптимизации, экспериментировали с GPU и искали способы использовать большие данные. Просто технические условия ещё не достигли критической точки, после которой преимущества масштабирования стали очевидны практически всем.
ImageNet и проблема данных
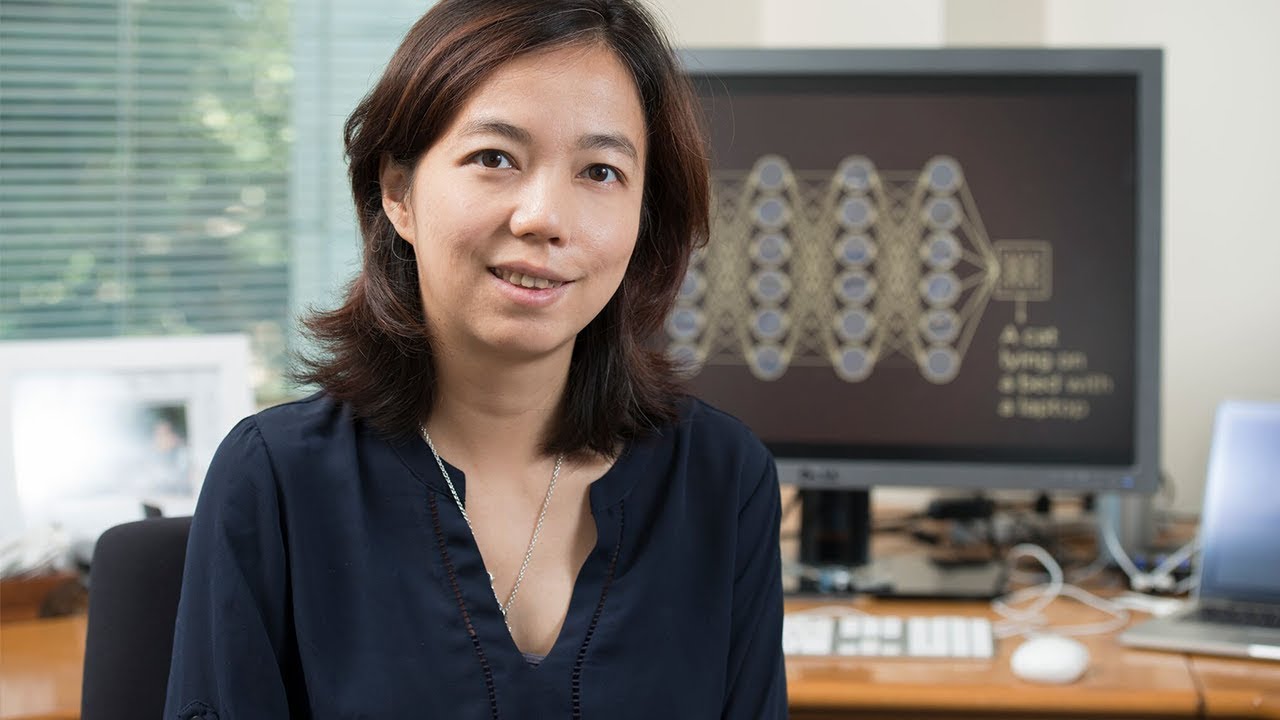 Для компьютерного зрения огромное значение имел проект ImageNet, который развивала Фэй-Фэй Ли с коллегами. Идея состояла в создании огромного набора изображений, организованных по множеству категорий и снабжённых информацией, необходимой для машинного обучения. Проект стал важным не только благодаря самому объёму данных, но и потому, что позволил исследователям сравнивать различные методы на одном крупномасштабном испытании.
До ImageNet компьютерное зрение часто работало с относительно небольшими наборами данных. Машина могла очень хорошо распознавать изображения внутри специально подготовленной задачи, но было трудно понять, насколько хорошо она будет работать в разнообразном реальном мире. ImageNet позволил значительно увеличить масштаб экспериментов и тем самым создал условия для настоящего соревнования между архитектурами и методами обучения. Вскоре стало очевидно, что глубокие нейронные сети особенно хорошо умеют использовать преимущества большого количества размеченных изображений.
AlexNet
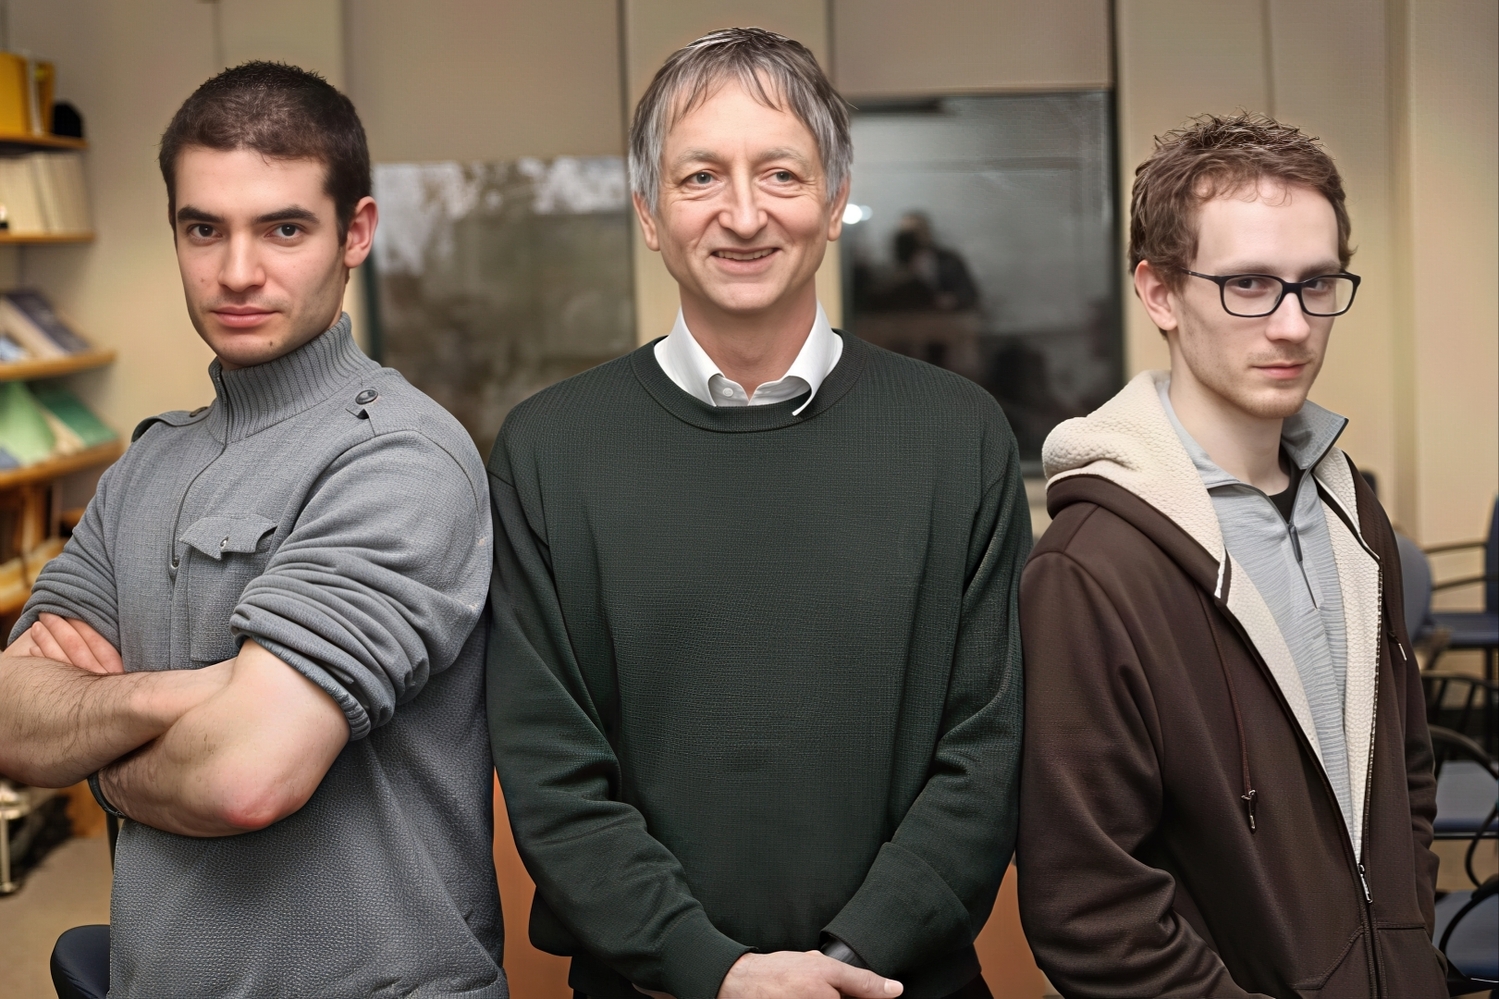 В 2012 году произошло событие, которое сегодня принято считать одним из важнейших поворотных моментов всей истории глубокого обучения. Алекс Крижевский, Илья Суцкевер и Джеффри Хинтон представили глубокую свёрточную сеть, которая стала известна как AlexNet. В соревновании ImageNet она показала результат, заметно превосходивший предыдущие методы. Авторы использовали около 1,3 миллиона обучающих изображений, сеть содержала примерно 60 миллионов параметров, а обучение значительно ускорялось благодаря GPU. AlexNet продемонстрировала, что глубокая нейронная сеть, обученная на достаточно большом массиве данных и оснащённая мощными вычислительными ресурсами, способна самостоятельно формировать чрезвычайно полезные представления изображений. Сочетание данных, архитектуры и вычислительной мощности наконец оказалось настолько эффективным, что даже исследователи, прежде не связывавшие с нейросетями особенно больших ожиданий, были вынуждены пересмотреть свои взгляды.
Однако было бы неправильно говорить, что именно в 2012 году придумали глубокое обучение. Скорее, в этот момент несколько десятилетий исследований сошлись вместе. Математические идеи существовали раньше, алгоритмы обучения появились задолго до AlexNet, свёрточные сети разрабатывались в 1980-е и 1990-е годы, а GPU и большие наборы данных лишь сделали всё это масштабируемым. Поэтому 2012 год важен прежде всего как момент практического перелома, а не как момент рождения всей технологии.
Машины научились слышать
Похожий процесс шёл в распознавании речи. Для компьютера человеческая речь — это не готовый текст, а сложный непрерывный акустический сигнал, в котором нужно выделить существенные закономерности. В 2010-е годы глубокие нейронные сети начали быстро улучшать акустическое моделирование речи и существенно изменили традиционный подход к автоматическому распознаванию. Это был принципиальный результат. Нейросети показали, что один и тот же общий подход способен работать с совершенно разными типами данных. В фотографии сеть учится находить пространственные закономерности, в речи — временные и акустические, а в тексте — статистические и структурные связи между символами и словами. Постепенно стало формироваться новое представление о нейронной сети как об универсальном механизме, который можно адаптировать к разным задачам.
Машины учатся на опыте
Одновременно развивалось обучение с подкреплением. В этом подходе системе не обязательно сообщать правильный ответ после каждого действия. Ей можно предоставить среду, в которой она совершает действия, получает награду или наказание и постепенно учится выбирать стратегии, ведущие к лучшему результату.
В 2013 году исследователи DeepMind представили работу «Игра в Atari с углубленным обучением с подкреплением». Нейронная сеть получала необработанные пиксели изображения игры Atari, а затем училась управлять игрой с использованием варианта Q-learning. Уже этот ранний эксперимент показал, что глубокая сеть может учиться непосредственно на визуальном сигнале и извлекать полезную стратегию поведения без вручную созданного для каждой игры набора правил.
Через несколько лет этот подход стал ещё более впечатляющим. В 2015 году была опубликована работа «Управление на уровне человека с помощью глубокого обучения с подкреплением», в которой Deep Q-Network демонстрировала сильные результаты на множестве игр Atari, используя единую общую архитектуру. Значение этих экспериментов было шире компьютерных игр: они показывали, что нейросеть может не только классифицировать данные, но и выбирать действия, наблюдать последствия и постепенно улучшать свою стратегию.
AlphaGo и машина, которая научилась играть в Го
В 2016 году DeepMind представила AlphaGo, и общественное внимание к нейросетям получило новый импульс. Игра Го считалась особенно сложной задачей для компьютера из-за огромного количества возможных позиций и вариантов продолжения. AlphaGo объединила глубокие нейронные сети с обучением подкреплением. Система использовала человеческие партии в качестве одного из источников обучения, а затем улучшала свою стратегию посредством игры с самой собой.
AlphaGo победила европейского профессионального игрока Фан Хуэя со счётом 5:0, а в 2016 году затем провела знаменитый матч против Ли Седоля. Это стало важным историческим моментом не потому, что компьютер впервые сыграл в интеллектуальную игру, а потому, что система показала: нейросети можно использовать не только для распознавания образов, но и для выработки сложной стратегии в среде, где правильное решение зависит от огромного количества возможных будущих состояний.
В 2017 году была представлена более общая система AlphaZero, которая училась играть в шахматы, Сёги и Го, начиная только с правил игры и используя в дальнейшем преимущественно игру с самой собой. Этот результат стал важным доказательством силы обучения с подкреплением в сочетании с глубокими нейронными сетями и поиском. Машине не обязательно было копировать человека ход за ходом: в определённых условиях она могла самостоятельно находить сильные стратегии, оценивая последствия своих действий.
Нейросети научились создавать
 До определённого момента основным вопросом было: «что находится на входе?» и «к какому классу относится результат?». Но затем исследователи всё чаще задавали другой вопрос: «может ли сеть сама создать новый объект?». В 2014 году Ян Гудфеллоу и его коллеги предложили Generative Adversarial Networks, или GAN. Идея заключалась в одновременном обучении двух сетей: одна создавала искусственные данные, а вторая пыталась отличить их от настоящих. Такой механизм оказался чрезвычайно плодотворным. Генератор постоянно пытался создавать более правдоподобные изображения, а дискриминатор — всё лучше находить подделки. В результате система могла постепенно научиться генерировать новые данные, напоминающие те, на которых она обучалась. GAN стали важной вехой на пути к современным генеративным системам, хотя позднее для высококачественной генерации изображений всё большее значение получили другие методы.
Параллельно развивались автокодировщики, вариационные модели и другие подходы к генеративному машинному обучению. Постепенно область стала двигаться от распознавания к синтезу. Машина должна была не только увидеть, что находится на картинке, но и научиться создавать картинку сама. Это изменение оказалось исключительно важным, потому что именно генерация впоследствии сделала искусственный интеллект понятным миллионам обычных пользователей.
Transformer меняет всё
В 2017 году исследователи Google опубликовали статью «Внимание - это все, что вам нужно», в которой предложили архитектуру Transformer. На тот момент главными инструментами работы с последовательностями были рекуррентные и свёрточные сети, а задача состояла в том, чтобы эффективно переводить и преобразовывать последовательности. Авторы показали, что эту задачу можно решать архитектурой, построенной вокруг механизма внимания, без обязательного использования рекуррентности. Transformer оказался не только конкурентоспособным по качеству, но и более удобным для эффективного параллельного обучения.
Суть механизма внимания можно объяснить на простом примере. Если человек читает длинное предложение, ему не обязательно одинаково сильно удерживать в памяти каждое слово. В конкретный момент он обращает особое внимание на те части фразы, которые помогают понять текущий смысл. Transformer позволяет модели вычислять подобные связи математически. При обработке одного фрагмента последовательности она может определить, какие другие фрагменты наиболее важны для текущего шага.
Именно эта возможность оказалась критически важной для будущих языковых моделей. Transformer хорошо масштабировался на больших объёмах данных и вычислений, а затем стало понятно, что одна и та же базовая архитектура может быть полезна далеко за пределами машинного перевода. Через несколько лет на Transformer будут построены практически все наиболее заметные большие языковые модели, которые изменят представление общества об искусственном интеллекте.
Чтобы нейросеть могла работать с человеческим языком, слова и символы необходимо представить в виде чисел. В современных системах текст обычно разбивается на токены, то есть последовательность фрагментов, которые затем преобразуются в математические векторы. Модель не «читает» текст так, как читает его человек. Она выполняет огромное количество операций над числовыми представлениями и через обучение на больших массивах текста постепенно приобретает способность учитывать статистические связи между различными фрагментами языка. Первоначальная формулировка задачи может показаться слишком простой: модель учится предсказывать следующий токен. Однако если такой процесс выполняется на огромном количестве текста, модель вынуждена освоить гораздо больше, чем кажется на первый взгляд. Чтобы хорошо продолжать предложения, она должна учитывать грамматику, устойчивые выражения, стилистические закономерности, фактические связи и контекст. В результате в параметрах модели формируется чрезвычайно сложное статистическое представление языка.
В 2018 году OpenAI показала, что большая предварительно обученная языковая модель может использоваться для множества различных задач. Впоследствии этот подход получил дальнейшее развитие и оказался фундаментальным для GPT-моделей. Модель сначала обучается на огромном количестве текста в общем режиме, а уже затем адаптируется для более конкретного поведения.
BERT, GPT и эпоха LLM
 В 2018 году Google представила BERT, показав, насколько эффективно Transformer можно использовать для понимания естественного языка. Одновременно OpenAI развивала собственную линию GPT-моделей, основанную на генеративном предобучении. У этих систем были разные архитектурные и обучающие особенности, но общий тренд становился очевидным: вместо создания отдельной маленькой модели для каждой задачи исследователи стремились сначала обучить большую универсальную систему на огромном объёме текста, а затем использовать полученные представления в самых разных приложениях. В 2019 году GPT-2 стала заметным шагом в этом направлении. Её крупнейшая версия содержала 1,5 миллиарда параметров. OpenAI демонстрировала, что модель способна не только продолжать текст, но и выполнять ряд задач без специального обучения под каждую из них. В 2020 году появилась GPT-3, содержащая 175 миллиардов параметров. Исследователи показали, что такая модель может выполнять новые задачи по нескольким примерам, помещённым непосредственно в контекст запроса. Этот эффект получил название «Обучение за несколько секунд». Модель не обязательно нужно было заново обучать после каждой задачи. Иногда достаточно было показать ей несколько примеров и сформулировать инструкцию.
На этом этапе исследовательское сообщество всё яснее видело: в нейросетях очень важен не только выбор алгоритма, но и масштаб. Большая модель, обученная на большем количестве данных и оснащённая достаточной вычислительной мощностью, способна получать новые качества без принципиального изменения базового механизма. Это не означает, что «больше всегда значит лучше». Архитектура, качество данных, обучение и оценка остаются критически важными. Но масштабирование стало самостоятельным исследовательским инструментом. Этот принцип объясняет, почему развитие ИИ в 2020-е годы происходило так быстро. Когда стоимость вычислений падает, а мощности растут, исследователи могут строить модели, которые ещё несколько лет назад были практически невозможны. Одновременно Интернет позволяет использовать всё большие объёмы данных. Чем больше становятся доступные вычислительные мощности, тем больше можно увеличить модель или продолжительность её обучения, а затем исследовать новые возникающие способности.
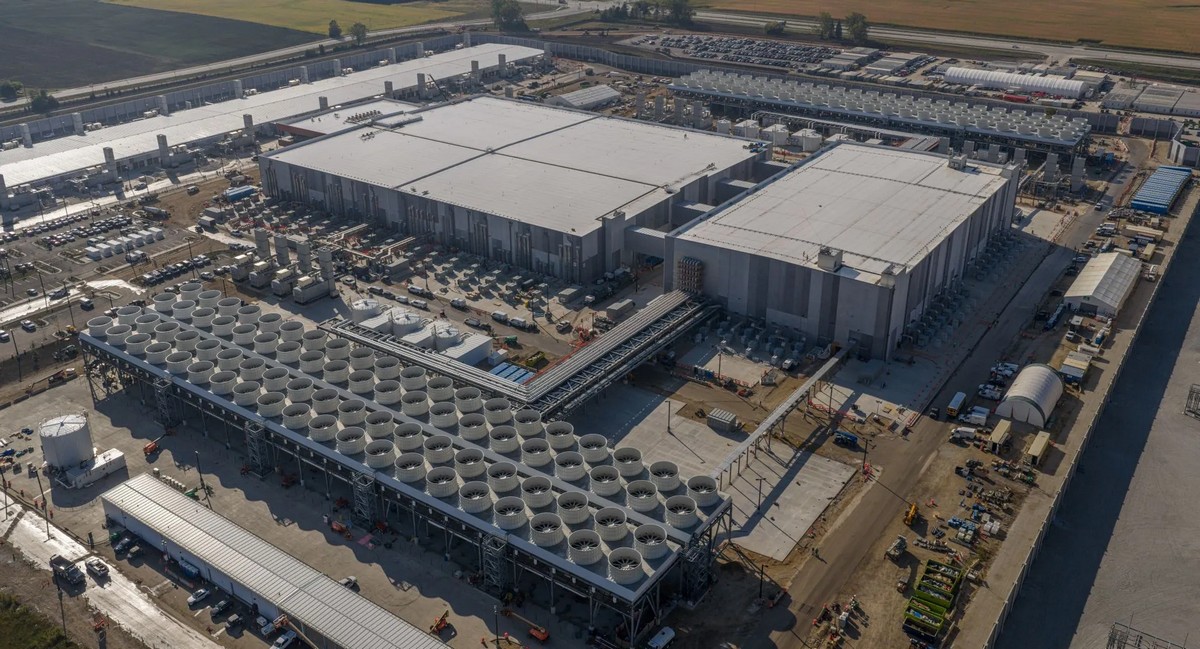
Именно здесь начинает формироваться современная индустрия искусственного интеллекта. Нейросеть уже нельзя рассматривать только как математический алгоритм. За ней стоят огромные дата-центры, ускорители вычислений, системы охлаждения, высокоскоростные сети, энергоснабжение и массивы данных. В 2026 году Stanford AI Index фиксирует уже глобальный масштаб этой инфраструктуры: только в Соединённых Штатах насчитывается 5427 дата-центров, а разработка передовых моделей и производство необходимых для них вычислительных компонентов стали важной частью мировой экономики.
Нейросеть научилась рисовать
Параллельно языковым системам развивались генеративные модели. Особое значение получили диффузионные модели. В 2020 году Джон Хо, Аджай Джейн и Питер Абби́ль представили Denoising Diffusion Probabilistic Models. Основная идея заключалась в том, чтобы постепенно добавлять шум к данным, а затем учить нейросеть выполнять обратный процесс и восстанавливать структуру. Если обученная модель начинает не с настоящего изображения, а с шума и постепенно очищает его, можно получить совершенно новый образ.
Идея кажется почти парадоксальной. Мы берём фотографию, превращаем её в шум, а затем обучаем компьютер делать обратное. Но математически этот процесс позволяет построить генеративную модель, которая учится распределению данных. Впоследствии подобные методы стали одной из главных основ генерации изображений высокого качества.
Другим важнейшим шагом стало связывание изображений с естественным языком. В 2021 году OpenAI представила CLIP — модель, обученную на примерно 400 миллионах пар «изображение — текст». Благодаря такому обучению модель могла связывать визуальные понятия с естественным языком и использовать текст для обращения к визуальным образам. Это был фундаментальный шаг к системам, которые понимают запрос вроде «собака в космическом костюме на поверхности Луны» не как набор независимых слов, а как описание визуальной сцены.
В 2021 году OpenAI представила DALL-E, генеративную систему, способную создавать изображения по текстовым описаниям. Качество первых результатов сильно уступает современным моделям, но сам принцип оказался чрезвычайно важным. Человеку больше не требовалось владеть графическим редактором или точно представлять техническую последовательность действий. Он мог описать желаемое изображение словами, а нейросеть пыталась превратить это описание в визуальный объект.
В 2022 году развитие диффузионных методов резко ускорилось. Работа «Синтез изображений высокого разрешения с использованием моделей скрытой диффузии» показала, как перенести диффузионный процесс в более компактное латентное пространство и использовать механизмы внимания для условной генерации изображений. Это снизило вычислительные требования и стало одной из важных технологических основ последующего взрыва генеративной графики.
К этому времени произошёл фундаментальный сдвиг в характере взаимодействия человека и компьютера. Раньше пользователь чаще указывал программе конкретную операцию и должен был знать, как именно её выполнить. Теперь он мог описывать желаемый результат человеческим языком. Компьютер уже не только исполнял явно сформулированные инструкции, но и интерпретировал намерение пользователя.
От генератора текста к помощнику
Большая языковая модель умеет продолжать текст, но этого недостаточно, чтобы стать удобным помощником. Пользователь ожидает другого поведения: он хочет задать задачу, получить связный ответ, продолжить разговор, уточнить детали и быть понятым с учётом контекста.
В 2022 году OpenAI подробно описала подход InstructGPT, в котором модель дополнительно обучалась следовать человеческим инструкциям с использованием данных, подготовленных людьми. Система становилась лучше не просто в продолжении текста, а в выполнении того, что человек просит её сделать. Именно этот переход от «генерируй продолжение» к «следуй инструкции» имеет огромное значение для истории современных чат-ботов.
Эпоха ChatGPT
 30 ноября 2022 года OpenAI представила ChatGPT как исследовательскую предварительную версию разговорного интерфейса. Его появление стало историческим событием потому, что сложная языковая модель впервые получила чрезвычайно простой интерфейс, доступный практически любому человеку. Пользователь мог просто написать вопрос обычными словами и начать диалог, не зная ничего о машинном обучении, нейронных сетях или программировании. Это изменило восприятие искусственного интеллекта. До этого нейросети воспринимались как технология, спрятанная внутри конкретного продукта. Пользователь мог не знать, что распознавание речи или обработка изображения выполняются нейронной сетью. ChatGPT сделал саму модель видимой. Человек впервые в массовом масштабе получил возможность разговаривать непосредственно с системой, которая обучалась на огромных массивах текста и могла выполнять множество различных задач.
При этом первые версии ChatGPT были далеко не безошибочными. Модель могла уверенно выдавать неправильные факты, придумывать несуществующие сведения, ошибаться в вычислениях и неправильно понимать намерение пользователя. Это стало одной из характерных особенностей больших языковых моделей. Они способны генерировать чрезвычайно убедительный текст, но убедительность ответа не гарантирует его истинность. Человеческий собеседник обычно различает несколько состояний: «я знаю», «я думаю», «я не уверен» и «я не знаю». Языковая модель устроена иначе. Она в основе своей не извлекает готовое утверждение из базы фактов с гарантированной проверкой истины. Она вычисляет вероятностное продолжение последовательности токенов на основании внутренних представлений, полученных во время обучения. Если правильный факт и красиво сформулированная ошибка оказываются статистически похожи, модель может выбрать ошибочный вариант. Её внутренний механизм не содержит автоматического универсального детектора истины. Именно поэтому современные системы всё чаще снабжаются внешним поиском, инструментами, вычислительными средами, базами знаний и механизмами проверки результата. Но даже сочетание этих методов не превращает любую нейросеть в безошибочный источник информации.
Эта проблема особенно важна в системах, которые начинают действовать самостоятельно. Ошибка в безобидном разговоре — неприятность. Ошибка модели, которая самостоятельно изменила файл, отправила сообщение, написала программный код или приняла решение во внешней системе, может иметь значительно более серьёзные последствия. Поэтому развитие возможностей ИИ неизбежно сопровождается развитием методов контроля, тестирования и безопасности.
14 марта 2023 года OpenAI представила GPT-4. В техническом отчёте модель описывалась как крупная мультимодальная система, способная принимать текст и изображения и генерировать текстовые ответы. Важно было не только увеличение возможностей самой языковой модели, но и изменение характера взаимодействия с ней. Пользователь мог дать модели фотографию, диаграмму или другой визуальный материал и попросить объяснить его содержание. Мультимодальность стала одной из главных тенденций всего последующего развития ИИ. Человек не воспринимает мир исключительно через текст. Мы одновременно используем зрение, слух, речь, пространственные представления и накопленные знания. Поэтому идея объединить разные типы данных в одной интеллектуальной системе выглядит естественным продолжением всей истории нейросетей.
В декабре 2023 года Google представила семейство Gemini и отдельно подчеркнула его мультимодальный характер. В последующие годы эта линия стала ещё более заметной: передовые модели получили возможность работать не только с текстом и изображениями, но и с аудио, видео, программным кодом и другими типами данных.
Машины научились рассуждать
Следующим вызовом стало качество решения сложных задач. Большая языковая модель может хорошо знать факты, уметь писать связный текст и даже сгенерировать программу, но сложные задачи требуют не только знаний, но и организации вычислений. Нужно разбить проблему на части, выбрать последовательность действий, выполнить промежуточные шаги, проверить результат и, возможно, вернуться назад после ошибки.
В 2024 и 2025 годах всё большее значение получили методы, при которых модель во время генерации может тратить дополнительное вычислительное время на решение сложной задачи. Смысл такого подхода не в том, что модель обязательно «думает как человек». Речь идёт о другом: вычислительный процесс становится длиннее и структурированнее, а система получает возможность выполнять больше промежуточных операций перед выдачей окончательного ответа.
В январе 2025 года DeepSeek представила модель R1 и отдельный вариант R1-Zero, исследуя обучение рассуждающему поведению с помощью обучения с подкреплением. В опубликованной работе авторы сообщали о появлении в процессе обучения более сложных стратегий решения, включая самопроверку и развитие многошагового рассуждения. Этот результат стал частью более широкой исследовательской тенденции: крупные модели начинают оптимизировать не только содержание ответа, но и сам процесс поиска решения. Важным стало и то, что похожее направление одновременно развивали разные лаборатории. Поэтому современная гонка ИИ всё чаще касается не просто размера модели. Исследователи экспериментируют с тем, сколько вычислений модель должна тратить на простой запрос и сколько — на сложную задачу, как она должна использовать внешние инструменты, как проверять промежуточные результаты и как организовать длительную последовательность действий.
От модели к агенту
Ещё несколько лет назад естественным интерфейсом ИИ считался вопрос и ответ. Пользователь написал запрос, модель сгенерировала текст, после чего работа закончилась. В 2026 году всё большее значение получает концепция агентов. Агентная система должна не просто выдать ответ, а самостоятельно выполнить задачу, для чего ей может потребоваться несколько действий во внешнем мире.
Представим, что пользователь просит изучить тему, собрать материалы, сравнить источники, провести расчёты и подготовить итоговый документ. Обычный чат-бот может попытаться сделать это в одном сообщении. Агентная система устроена иначе: она способна разбить задачу на этапы, выполнять поиск, использовать программный код, открывать документы, обращаться к инструментам, проверять промежуточные результаты и затем формировать итог. Разница между этими подходами принципиальна. В первом случае модель прежде всего генерирует ответ. Во втором она участвует в процессе работы. Современные исследования и продукты всё чаще движутся именно в эту сторону. Google в сентябре 2026 года, например, описывает новые версии Gemini как системы для сложных агентных сценариев, многошагового рассуждения и работы в реальном времени с визуальным контекстом. OpenAI в сентябре 2026 года одновременно развивает модели и среды, предназначенные для работы с компьютерными инструментами и длительными задачами. Эти разработки показывают, насколько быстро центр тяжести смещается от генерации отдельного ответа к выполнению последовательности действий.
Что происходит с нейросетями сегодня?
Искусственный интеллект развивается сразу по нескольким направлениям, и уже трудно описать всю отрасль одной моделью или одной архитектурой. Передовые системы объединяют обработку текста, изображений, речи и видео, используют расширенные контекстные окна, умеют подключать внешние инструменты и в ряде случаев могут тратить дополнительное вычислительное время на сложное рассуждение. В сентябре 2026 года OpenAI выпустили новое поколение моделей GPT-6, включая Astra для сложной многошаговой работы и Sol и Luna для других сценариев. Эти модели доступны в разных средах и не должны рассматриваться как одна универсальная сущность: современные ИИ-системы всё чаще представляют собой целые семейства моделей и инструментов.
 Google параллельно развивает поколение Gemini 3.8. В сентябре 2026 года компания представила модели Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking, ориентированные на естественный голосовой диалог, работу с визуальным контекстом, многошаговое рассуждение и выполнение фоновых задач с инструментами. В течение того же месяца Google представила Live Avatar, объединяющий разговорные возможности с потоковой генерацией видео и визуальным представлением собеседника. Всё это показывает, что современная граница развития ИИ постепенно перемещается от простого «ответа на запрос» к постоянно действующей мультимодальной системе, которая может одновременно слышать, видеть, говорить, рассуждать и выполнять операции.
Но было бы неправильно делать из этих достижений вывод, что ИИ теперь просто стал «умнее человека» во всех отношениях. Данные Stanford AI Index 2026 показывают гораздо более сложную картину. Передовые модели демонстрируют очень высокие результаты на ряде научных, математических и программных тестов, однако их способности остаются неравномерными. В отчёте используется выражение «рваная граница» возможностей: система может выдавать результаты чрезвычайно высокого уровня в одной области и при этом неожиданно слабо справляться с задачей, которая человеку кажется элементарной.
Развитие ИИ невозможно рассматривать только как вопрос программирования. Модель работает внутри огромной технологической цепочки, включающей производство полупроводников, строительство дата-центров, энергетику, системы охлаждения, высокоскоростные сети и хранение данных. США располагают 5427 дата-центрами, что значительно больше, чем любая другая отдельная страна, а значительная часть наиболее передовых вычислительных чипов производится одной тайваньской литографической экосистемой, от которой зависит глобальное предложение ускорителей для ИИ. Поэтому современная нейросеть представляет собой одновременно программный алгоритм и физическую инфраструктуру. Когда человек отправляет запрос в крупную модель, в этот момент работают не только математические формулы внутри программы. Запускается цепочка вычислений на специализированных ускорителях, данные передаются через сети, система получает доступ к памяти и хранилищам, расходуется электричество, а выделяемое тепло должно отводиться. Отсюда и возникает важная особенность нынешней эпохи: ИИ становится одновременно вопросом информатики, промышленности, энергетики и экономики.
Открытые модели и конкуренция подходов
Ещё одна важная тенденция последних лет связана с распространением моделей, чьи параметры доступны разработчикам в значительно большей степени, чем у полностью закрытых систем. Этот процесс особенно заметно ускорился в 2023–2025 годах и продолжился в 2026-м. Открытые и открыто распространяемые модели позволяют университетам, независимым разработчикам и компаниям адаптировать технологии под собственные задачи, создавать локальные решения и экспериментировать с архитектурами, не полагаясь исключительно на один облачный сервис. При этом рынок не пришёл к единственной модели развития. Одни лаборатории делают ставку на самые крупные централизованные системы, которые работают в гигантских дата-центрах. Другие развивают относительно компактные модели, способные работать локально на персональном компьютере, смартфоне или специализированном устройстве. Третьи создают системы, которые объединяют несколько моделей и инструментов. Поэтому будущее нейросетей, по всей видимости, не будет представлять собой просто одну-единственную программу, которая постепенно заменяет все остальные.
Почему данные важны, но не решают всё
 За последние годы часто повторяли фразу о том, что данные являются «новой нефтью». Сравнение спорное, однако в нём есть рациональное зерно. Нейронная сеть действительно нуждается в огромном количестве примеров, из которых она извлекает закономерности. Тексты позволяют учиться языку, изображения — визуальным представлениям, видео — динамике, а код — структурам программ. Чем больше разнообразных данных доступно, тем больше возможностей получить сложные внутренние представления. Но Интернет дал нейросетям не только знания, а ещё и огромное количество ошибок. В сети есть старые статьи, противоречивые сведения, выдумки, спам, повторы, плохой код и многочисленные формы дезинформации. Поэтому увеличение объёма данных не означает автоматического увеличения качества. Важны методы обучения, качество источников и последующая проверка результатов. Именно здесь становится понятна одна из причин, по которой современные модели могут одновременно демонстрировать впечатляющее знание и уверенно выдавать неправду.
Нейросеть не мозг
Название «нейронная сеть» легко создаёт неправильное впечатление, будто современная модель представляет собой цифровую копию мозга. Это не так. Биологический мозг намного сложнее любой современной искусственной нейросети. В нём работают различные типы нервных клеток, химические процессы, сложные механизмы пластичности, обратные связи, взаимодействие с телом и сенсорными системами. Современная нейросеть, напротив, построена из математических операций над числовыми представлениями.
Связь с биологией носит прежде всего исторический и концептуальный характер. Исследователи действительно вдохновлялись устройством мозга, а ранние модели пытались использовать некоторые его принципы. Но со временем искусственные нейросети стали самостоятельной математической технологией. Их архитектуры уже нельзя напрямую понимать как инженерную копию человеческой нервной системы. Именно поэтому вопрос о том, «думает ли» нейросеть так же, как человек, в научном смысле некорректен. Гораздо продуктивнее исследовать конкретные способности системы, методы её обучения, устойчивость, перенос знаний, способность планировать и использовать инструменты, а также то, какие процессы происходят внутри модели. В этом отношении современная наука всё больше переходит от философского вопроса «является ли машина разумной?» к более конкретным измерениям поведения и возможностей.
История нейросетей началась не в 2022 году
Массовое распространение ChatGPT создало ощущение, будто именно в ноябре 2022 года возник современный искусственный интеллект. На самом деле ChatGPT стал массовым интерфейсом для технологий, которые развивались гораздо дольше. До него существовали GPT-3, GPT-2, BERT, AlphaGo, глубокие свёрточные сети, генеративные модели изображений, Transformer и десятки других систем. Даже сама идея большой предобученной языковой модели сформировалась задолго до ChatGPT. А Transformer возник в 2017 году. Диффузионные модели получили важные основы в 2020 году. CLIP и другие системы связали язык с изображениями в 2021 году. Поэтому ChatGPT правильнее считать не началом всей технологии, а моментом её масштабного выхода в массовое пользовательское пространство.
Именно это различие помогает понять, почему революция произошла настолько быстро. Техническая революция к тому моменту уже шла много лет, но её результаты оставались внутри исследовательских лабораторий и специализированных продуктов. Когда появился простой интерфейс, не требующий от человека специальных знаний, миллионы пользователей буквально за короткое время получили доступ к возможностям, над которыми исследователи работали десятилетиями.
Точно так же нельзя сказать, что нейросети появились вместе с AlexNet. В 2012 году лишь совпало несколько обстоятельств, которые до этого существовали раздельно. Теория искусственных нейронов появилась в 1940-е годы. Перцептрон возник в 1950-е. Ограничения простых сетей были подробно исследованы в 1960-е. Методы обучения многослойных систем развивались десятилетиями. Свёрточные сети появились задолго до AlexNet. Компьютерная техника постепенно становилась мощнее, а Интернет создавал всё более крупные массивы данных. AlexNet стала моментом, когда эта цепочка наконец достигла критической точки. Сеть смогла воспользоваться большим объёмом данных, графическими процессорами и достаточно эффективными методами обучения, чтобы показать резкий скачок качества. Это был не старт с нуля, а момент, когда долго копившаяся технология стала очевидно полезной в планетарном масштабе.
 Многие научные идеи становятся по-настоящему революционными не сразу после появления. Между первой математической моделью нейрона и современными большими нейросетями прошло более восьмидесяти лет. Между LSTM и современными большими языковыми моделями прошло больше двадцати лет. Между первыми генеративными идеями и массовыми генераторами изображений прошло ещё больше времени. Причина заключается в том, что научная идея и готовая технология — не одно и то же. Чтобы метод заработал, могут потребоваться подходящие данные, более быстрый компьютер, новая система памяти, более дешёвый способ хранения информации, другой алгоритм оптимизации или удобный интерфейс. Иногда исследователи десятилетиями не могут полноценно реализовать идею просто потому, что необходимой инфраструктуры ещё не существует. В этом смысле история ИИ очень похожа на историю других технологий. Самолёты стали возможны не только благодаря идее полёта, но и благодаря двигателям, материалам, аэродинамике и промышленности. Интернет возник не просто из идеи соединить компьютеры, а благодаря телекоммуникационной инфраструктуре, стандартам и дешёвой вычислительной технике. Нейросетевой бум тоже стал результатом соединения множества элементов.
Если сравнить нейрон Маккаллока и Питтса 1943 года с современной системой, разница кажется почти абсурдной. Первая модель была математической схемой, описывающей работу очень простого искусственного элемента. Сегодня модель может содержать огромное количество параметров, работать сразу с несколькими типами данных, использовать внешние инструменты и выполнять длинные последовательности вычислений. Но на фундаментальном уровне между ними существует очень глубокая связь. И там, и там есть математические элементы, объединённые в сеть, параметры, определяющие силу связей, и процесс настройки этих параметров. Разумеется, современные архитектуры намного сложнее первых моделей, а используемые операции далеко ушли от простого биологического нейрона. Однако базовая идея сохранилась: большое количество относительно простых вычислений может сформировать сложную систему представлений и поведения.
От искусственного нейрона к искусственному работнику
С исторической точки зрения трудно делать уверенные прогнозы. В прошлом исследователи неоднократно ошибались и в сторону чрезмерного оптимизма, и в сторону чрезмерного скептицизма. Нейросети считали почти бесперспективными, когда не хватало вычислений; затем их считали близкими к универсальному интеллекту, когда появлялись впечатляющие демонстрации; после этого вновь обнаруживались ограничения. Подобные циклы повторялись несколько раз. Поэтому наиболее надёжный вывод из всей истории состоит не в том, что нынешние системы обязательно приведут к определённому будущему, а в том, что технологический потенциал зависит от сочетания нескольких факторов. Если продолжат быстро развиваться вычисления, данные, методы обучения, архитектуры, робототехника и инструменты взаимодействия с внешним миром, возможности нейросетей могут заметно расшириться. Но расширение возможностей не гарантирует автоматического решения проблем понимания, надёжности, безопасности и контроля.
Современная нейросеть уже не похожа на устройство, которое люди представляли в начале этой истории. Первоначальная мечта заключалась в том, чтобы создать нечто вроде искусственного мозга. Реальность пошла другим путём. Вместо точного копирования мозга человечество создало совершенно иной класс вычислительных систем, вдохновлённых отдельными принципами биологической нервной системы, но развивающихся уже по собственным математическим законам. Сегодня мы видим результат этого длинного пути в повседневной жизни. Человек разговаривает с моделью, показывает ей фотографию, просит объяснить документ, поручает написать программу, дать идею для проекта или обработать данные. Всё это выглядит как единая технология, но за ней скрывается почти век истории. В ней есть работы математиков 1940-х, эксперименты с перцептронами 1950-х, споры исследователей 1960-х, труд десятилетий, когда направление переживало периоды охлаждения, развитие backpropagation, компьютерного зрения, рекуррентных сетей, машинного перевода, обучения с подкреплением, GPU, больших данных и Transformer.
Поэтому история нейросетей — это не история внезапного появления машины, которая однажды проснулась и стала разумной. От первой модели искусственного нейрона до современных систем прошёл огромный путь, но в самом его центре остаётся одна и та же фундаментальная идея: сложное поведение может возникать не из набора вручную прописанных правил, а из обучения огромной системы взаимодействующих элементов. Сегодня модели переходят от обработки отдельных запросов к длительной работе, от текста к мультимодальности, от готовых ответов к рассуждению и от пассивного диалога к использованию инструментов. Что получится из этого через десять или двадцать лет, сегодня невозможно предсказать. Но уже ясно одно: технологии, которые ещё недавно казались лабораторным экспериментом, превратились в одну из крупнейших вычислительных платформ XXI века, и современный этап этой истории является очередным поворотом в развитии идеи, которой больше восьмидесяти лет.
95 просмотров · 19.10.2026
Какой ИИ заменит ChatGPT в России? Большой обзор текстовых нейросетей.
Искусственный интеллект уже перестал быть технологией будущего — сегодня нейросети активно используют в бизнесе, образовании и повседневной жизни. Но как выбрать подходящий инструмент среди множества решений? В этом обзоре мы детально сравним семь ведущих ИИ‑сервисов последних лет: ChatGPT, Alice AI, Claude, Grok, Gemini, GigaChat и DeepSeek. Разберём их ключевые возможности, особенности работы с русским языком, доступность в России, платные и бесплатные функции, а также реальные ограничения. Цель — помочь вам найти нейросеть, которая максимально соответствует вашим задачам.
Российские учёные улучшили ИИ с помощью мата
Российские учёные из Института AIRI, Высшей школы экономики и Университета Иннополис сделали неожиданный шаг в развитии искусственного интеллекта: они научили нейросети использовать мат как инструмент сжатия текста. Вместо того чтобы просто удалять или заменять нецензурные выражения, исследователи задались вопросом — а можно ли использовать их как «смысловую упаковку»? Оказалось, что одно матерное слово способно заменить целую фразу, сохранив при этом суть. На этом принципе команда построила алгоритм, который сокращает тексты, экономя вычислительные ресурсы без потери смысла. При этом цель не в том, чтобы ИИ начал ругаться, а в том, чтобы научить его глубже понимать русский язык — и работать эффективнее.
ИИ посмотрел глазами людей
Учёные из Института Вейцмана сделали шаг к прочтению зрительных образов человека. Система Brain‑IT по данным фМРТ восстанавливает то, что видит человек: ИИ анализирует сигналы мозга и превращает их в узнаваемые изображения. Этот прорыв ставит перед обществом непростые вопросы о приватности сознания.
Всё о «цифровой мухе»
Что будет, если попробовать перенести мозг живого существа в компьютер? Учёные уже сделали первый шаг в этом направлении: они подробно восстановили нервную систему плодовой мушки и превратили её в работающую цифровую модель. Теперь виртуальная муха умеет ориентироваться в окружающем мире, реагировать на сигналы, играть в компьютерные игры и даже управлять виртуальным автомобилем. Но означает ли это, что внутри компьютера появилась настоящая цифровая жизнь?
GPT-6 Astra: машина, которая слишком хороша, чтобы быть машиной
В сентябре 2026 года мир столкнулся с поворотным моментом в истории искусственного интеллекта: OpenAI представила GPT‑6 Astra — систему, которая самостоятельно выстраивает цепочки действий, пользуется программами, находит уязвимости и решает многоэтапные задачи так, будто обладает настоящим мышлением. Способность модели действовать автономно заставляет всерьёз задуматься: не стоим ли мы на пороге эры общего искусственного интеллекта — и где вообще пролегает граница между алгоритмом и разумным существом?
Россия ищет границы для искусственного интеллекта
Россия стремительно осваивает искусственный интеллект — но вместе с новыми возможностями приходит и тревога: люди уже не могут отличить контент, созданный Машиной, от человеческого. На фоне растущего недоверия общество требует прозрачности, власти ищут баланс между контролем и развитием технологий, а бизнес вынужден подстраиваться под меняющиеся ожидания аудитории. В центре этих противоречий — простой, но крайне спорный вопрос: должна ли каждая строчка, картинка или видео, рождённые алгоритмами, нести на себе чёткую метку «Сделано ИИ»?
В российских школах могут отменить домашние задания
Искусственный интеллект всерьёз меняет школьное образование: нейросети решают задачи быстрее учеников, а домашние задания рискуют превратиться в формальность. Разбираемся, почему традиционная «домашка» теряет смысл в эпоху ИИ, к каким последствиям это ведёт и сможет ли школа адаптироваться к новым реалиям.
В России хотят ввести цензуру для Искусственного интеллекта
В России готовят масштабное ужесточение контроля над искусственным интеллектом: государство может ввести двойную цензуру — блокировать «неправильные» запросы пользователей ещё до обработки и фильтровать ответы нейросетей по утверждённому перечню запрещённых тем. Законопроект Минцифры предусматривает маркировку контента, созданного ИИ, классификацию систем по уровню «риска» и даже особые правила определения интеллектуальных прав — всё с прицелом на соблюдение цензурных ограничений.
В России могут запретить Искусственный интеллект
К 2027 году рынок искусственного интеллекта в России может кардинально измениться: Минцифры подготовило законопроект, позволяющий ограничивать или запрещать работу зарубежных нейросетей. Под угрозой — популярные сервисы ChatGPT, Claude и Gemini, отправляющие данные пользователей за рубеж. В то же время открытые модели вроде Qwen и DeepSeek могут стать альтернативой: их получится безопасно развернуть на российской инфраструктуре. Разбираемся, какие правила установят для ИИ‑платформ и как это повлияет на пользователей и бизнес.
Искусственный интеллект без программирования
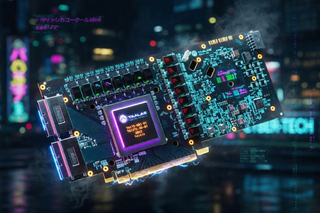
Канадский стартап Taalas совершил технологический прорыв: компания представила чип HC1, в архитектуру которого напрямую «впаяна» нейросеть Llama 3.1 8B. Решение обеспечивает рекордную скорость обработки — до 17 000 токенов в секунду, в 10 раз опережая топовые GPU, при этом потребляет в 10 раз меньше энергии и обходится в 20 раз дешевле в производстве. Разбираемся, как устроена революционная технология и способна ли она изменить рынок искусственного интеллекта.